0
ИИ-селекция каннабиса: практический взгляд на работу с данными
Селекция каннабиса по-прежнему опирается на проверенные шаги: отбор лучших растений, анализ их химического профиля, повторные циклы скрещивания и проверка стабильности признаков в нескольких поколениях. Оценивается структура куста, плотность и форма соцветий, сроки цветения, воспроизводимость показателей при одинаковых условиях. Этот фундамент никуда не исчез и остается основой любой серьезной селекционной программы.
Однако за последние годы изменилась глубина и детализация информации, сопровождающей каждую линию. Помимо визуальной оценки и стандартного анализа ТГК и КБД появились генетические панели, позволяющие видеть вариации ДНК, расширенные профили каннабиноидов и терпенов, детальные журналы микроклимата, протоколы освещения и питания, данные по реакции на стрессовые факторы. В рамках одной программы это могут быть сотни количественных показателей по каждой линии, собранных на разных этапах цикла.
Работа с таким массивом данных требует систематизации и инструментов, способных анализировать множество переменных одновременно. Машинное обучение становится средством, которое помогает выявлять устойчивые закономерности между генотипом, химическим составом и условиями выращивания. Это добавляет к традиционной селекции слой количественного анализа, позволяющий принимать решения на более структурированной основе.
Что именно анализирует алгоритм
В основе химического профиля каннабиса лежит работа ферментов, которые кодируются определенными генами. Эти ферменты участвуют в последовательных биохимических реакциях, формирующих каннабиноиды. Вариации в последовательности ДНК, различия в числе копий генов и особенности регуляции экспрессии могут менять активность этих ферментов и, как следствие, соотношение ТГК, КБД и других соединений.
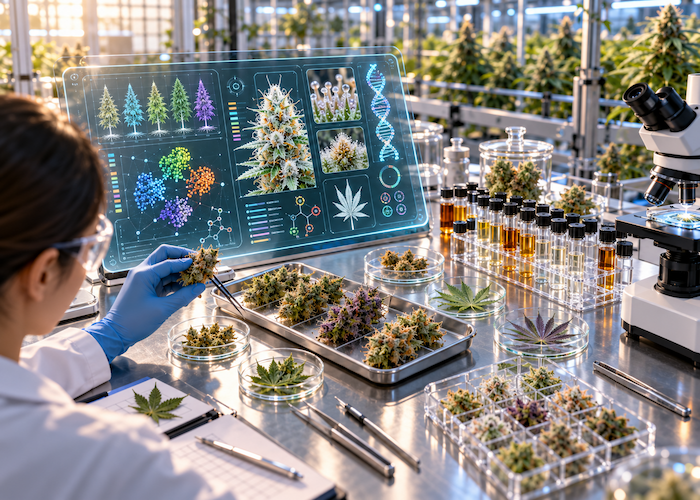
Секвенирование позволяет выявлять различия в ДНК с высокой детализацией, включая отдельные нуклеотидные замены и структурные вариации. Параллельно проводится химический анализ, который фиксирует точные концентрации каннабиноидов и терпенов. Таким образом формируются два взаимосвязанных массива данных: генетический и химический.
Алгоритм сопоставляет эти массивы и ищет повторяющиеся комбинации. Он анализирует, какие генетические маркеры чаще встречаются у растений с определенным химическим профилем, и оценивает вклад каждого из них в итоговый результат. Модель не «создает» новые признаки и не меняет генетику растения. Она вычисляет вероятность того, что конкретная комбинация генетических вариантов приведет к нужному профилю.
Это дает возможность проводить предварительный отбор до завершения полного цикла выращивания. Если вероятность достижения целевых показателей низкая, растение можно исключить из программы на раннем этапе, сосредоточив ресурсы на более перспективных линиях.
Среда как переменная в формуле
Каннабис чувствителен к условиям выращивания. Изменение освещения, температуры, влажности или режима питания способно повлиять на концентрацию каннабиноидов даже при одинаковом генотипе. Это означает, что химический профиль формируется под воздействием как генетики, так и среды.
Поэтому в цифровых моделях учитываются не только данные ДНК, но и параметры выращивания. Температура воздуха и субстрата, спектр и интенсивность света, режим полива, плотность посадки — все это включается в анализ как дополнительные переменные. Такой подход позволяет различать генетическую предрасположенность и реакцию на условия, снижая риск ошибочной интерпретации.
Особенно важно учитывать среду при оценке устойчивости. Линия может демонстрировать стабильный профиль при колебаниях влажности или температуры, что говорит о ее адаптивном потенциале. Алгоритм фиксирует такие случаи и связывает их с конкретными генетическими комбинациями, помогая выявить растения, которые сохраняют характеристики в разных условиях выращивания.
Работа с редкими профилями
Развитие лабораторной аналитики существенно расширило понимание химического разнообразия каннабиса. Современные методы позволяют выявлять минорные каннабиноиды, присутствующие в очень низких концентрациях, которые ранее могли оставаться вне отчетности. Такие профили встречаются нечасто и могут быть связаны с редкими сочетаниями генетических маркеров или особенностями регуляции синтеза.
В больших коллекциях, где число образцов измеряется сотнями, найти подобные варианты вручную сложно. Даже при наличии полного химического анализа сопоставить его с генетическими данными по каждой линии требует значительных ресурсов. Алгоритмы машинного обучения помогают выделить линии, которые статистически отклоняются от основной группы. Они анализируют совокупность признаков и находят образцы с нестандартными комбинациями.
В расчет включаются генетические маркеры, вариации числа копий генов и химические показатели. Модель оценивает, какие экземпляры имеют профиль, отличающийся от типичного распределения. После цифрового отбора растения проходят повторный лабораторный анализ, чтобы подтвердить стабильность показателей и исключить влияние случайных факторов.
Гибридизация с расчетом вероятностей
ИИ применяется и при планировании скрещиваний. Анализ генетической дистанции между родительскими формами позволяет оценить степень их различий и возможное сочетание аллелей в потомстве. Учитываются известные ассоциации между генетическими маркерами и фенотипическими признаками, включая химический профиль и устойчивость к стрессам.
Модель рассчитывает вероятное распределение характеристик в первом поколении и показывает диапазон возможных вариантов. Это не гарантированный результат для каждого растения, а количественная оценка вероятностей.
Такой подход снижает долю случайных комбинаций и позволяет более рационально планировать программу отбора. Селекционер получает инструмент для выбора родительских пар на основе расчетов, что повышает управляемость процесса и эффективность использования ресурсов.
Требования к данным
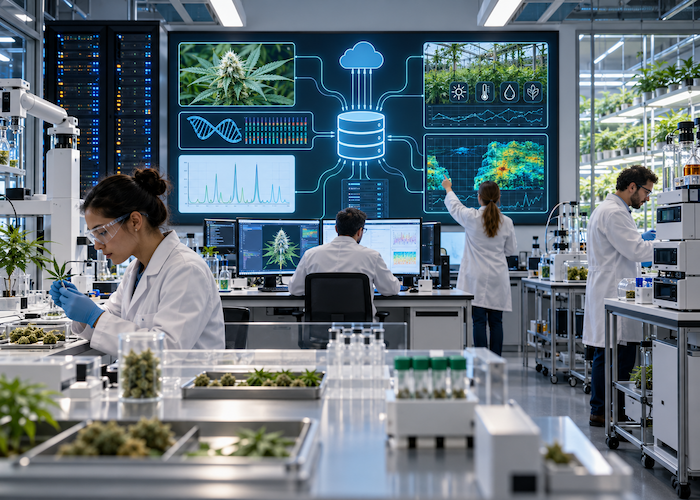
Точность цифровой селекции напрямую зависит от стандартизации процессов. Генетические тесты должны проводиться по единым протоколам, с сопоставимой глубиной секвенирования и одинаковыми критериями обработки данных. Если разные партии анализируются по разным методикам, это создает искажения, которые могут быть ошибочно интерпретированы как биологические различия.
Химический анализ также должен быть сопоставимым между партиями. Важны единые методы экстракции, калибровка оборудования, контроль повторяемости измерений и прозрачность расчетов. Даже незначительные расхождения в лабораторной процедуре способны повлиять на итоговые концентрации и снизить точность модели.
Условия выращивания необходимо фиксировать подробно. Температура, влажность, интенсивность и спектр света, состав субстрата, режим полива и питания должны быть задокументированы. Без учета этих параметров сложно корректно разделить влияние генетики и среды, что снижает надежность прогноза.
Каннабис пока формирует крупные геномные базы данных. По мере их расширения и накопления репрезентативных выборок модели становятся устойчивее и лучше работают на разных популяциях. Однако алгоритмы выявляют статистические связи между параметрами. Они показывают, какие признаки часто встречаются вместе, но не объясняют механизм их взаимодействия. Биологическая интерпретация и проверка гипотез остаются задачей специалиста.
Практический вывод
ИИ в селекции каннабиса — это инструмент обработки сложной и многомерной информации. Он объединяет генетические данные, химический профиль и параметры среды в единую систему анализа, позволяя рассматривать линию в контексте большого числа факторов.
При достаточном объеме качественных и стандартизированных данных цифровые модели помогают ускорить первичный отбор, выявлять редкие профили и более точно планировать гибридизацию. Селекция становится более управляемой и основанной на количественной оценке вероятностей, при сохранении ключевой роли человека в принятии решений и интерпретации результатов.
Источники:
- Najafabadi, M. Y. (2025). Machine learning-enhanced multi-trait genomic prediction for optimizing cannabinoid profiles in Cannabis sativa. The Plant Journal.
- Çay, T. (2024). Prediction of THC levels in Cannabis species using machine learning methods. Bozok Journal of Agriculture and Natural Sciences, 3(2), 125–136.
- Houston, A. (2025, December 10). Marijuana breeders can use AI to design new strains, study demonstrates. Marijuana Moment.